زنجیره تفکر (Chain of Thought) چیست؟
زنجیره تفکر (Chain of Thought یا بهاختصار CoT) تکنیکی در پرامپتنویسی است که مدل زبانی بزرگ (LLM) را وادار میکند پیش از رسیدن به پاسخ نهایی، مسئله را گامبهگام حل کند و مراحل استدلال خود را بنویسد. بهجای اینکه مدل مستقیم سراغ جواب برود، ابتدا گامهای میانی را میچیند و سپس نتیجه را از دل آنها بیرون میکشد. این تکنیک در فارسی با نامهای «زنجیره فکر» و «تفکر زنجیرهای» هم شناخته میشود.
تفاوت را با یک مسئله ساده ببینید:
- پرسش: علی ۵ مداد دارد. او ۲ بسته ۳تایی مداد دیگر میخرد و بعد ۴ مداد به دوستش میدهد. حالا چند مداد دارد؟
- پاسخ مستقیم (پرامپت معمولی): ۹ مداد.
- پاسخ با زنجیره تفکر (CoT): علی در ابتدا ۵ مداد دارد. دو بسته ۳تایی یعنی ۶ مداد جدید، پس مجموع میشود ۱۱ مداد. بعد ۴ مداد میدهد و ۷ مداد برایش میماند. پاسخ نهایی: ۷ مداد.
در پاسخ مستقیم، مدل بدون نوشتن هیچ مرحلهای به عدد غلط رسیده است؛ در پاسخ گامبهگام، هر مرحله قابل بررسی است و خطا کمتر پنهان میماند. همین ویژگی باعث شده تکنیک CoT یکی از پایههای اصلی مهندسی پرامپت (Prompt Engineering) باشد.
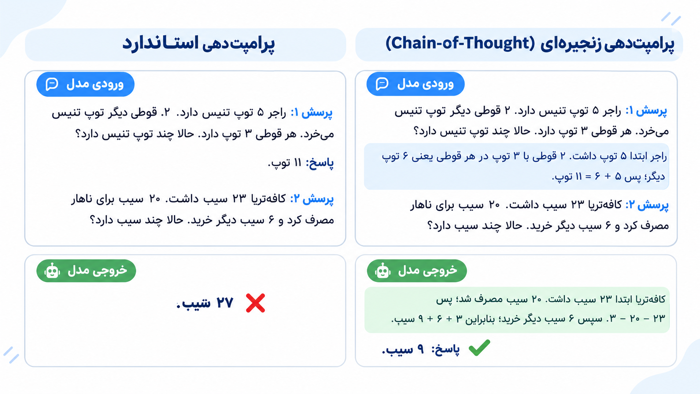
تفاوت عملکرد مدل زبانی در پاسخگویی مستقیم در مقایسه با استدلال گامبهگام (CoT)
چرا زنجیره تفکر دقت مدلهای زبانی بزرگ (LLM) را بالا میبرد؟
زنجیره تفکر دقت را بالا میبرد، چون مسئلهای پیچیده را به چند گام کوچک و قابلحل تقسیم میکند و به مدل فرصت میدهد برای هر گام «محاسبه» کند. مدلهای زبانی توکنبهتوکن (کلمهبهکلمه) تولید میشوند؛ هر توکن (Token) یا کلمهای که مدل مینویسد، خودش بخشی از ورودی در پنجره زمینه (Context Window) برای تولید کلمه بعدی است. وقتی مراحل میانی نوشته شوند، عملاً بهعنوان یک «حافظه کاری» (Working Memory) عمل میکنند و مدل میتواند به آنها تکیه کند.
استدلال چندمرحلهای و نقش گامهای میانی
در مسائل چندمرحلهای (ریاضی، منطق، برنامهریزی، تحلیل داده)، یک اشتباه کوچک در ابتدای مسیر کل پاسخ را خراب میکند. گامهای میانی سه کمک اصلی به مدل میکنند:
- حفظ زمینه (Context): نتیجه هر مرحله روی صفحه میماند و مرحله بعد از آن استفاده میکند.
- جلوگیری از پرش منطقی: مدل مجبور نیست یکجا از صورت مسئله به جواب نهایی بپرد.
- قابلیت بازبینی و دیباگ: شما (یا خود مدل) میتوانید دقیقاً ببینید خطا در کدام گام رخ داده است.
منشأ تکنیک: مقاله Wei و همکاران (۲۰۲۲)
این تکنیک با مقالهای از جیسون وی (Jason Wei) و همکارانش در بخش تحقیقات گوگل (Google Brain) با عنوان «Chain-of-Thought Prompting Elicits Reasoning in Large Language Models» در سال ۲۰۲۲ معرفی شد. ایده کلیدی مقاله ساده بود: اگر در پرامپت چند نمونه بیاوریم که پاسخشان شامل مراحل استدلال است، مدلهای زبانی بزرگ هم برای سؤال جدید مراحل استدلال را مینویسند و دقتشان بالاتر میرود.
نویسندگان این روش را روی مدلهایی مانند PaLM با ۵۴۰ میلیارد پارامتر آزمودند و بهبود چشمگیری در مسائل ریاضی کلاسی (بنچمارک GSM8K)، استدلال عقل سلیم (Commonsense Reasoning) و استدلال نمادین گزارش کردند. نکته مهم دیگر مقاله این بود که این قابلیت یک «ویژگی نوظهور» (Emergent Ability) است که بیشتر در مدلهای بسیار بزرگ ظاهر میشود و در مدلهای کوچک چندان کارساز نیست. برای بررسی نمودارها و ارقام دقیق آزمایشها، به متن اصلی مقاله پژوهشی Chain-of-Thought Prompting در arXiv مراجعه کنید.
انواع پرامپتنویسی Chain of Thought: مقایسه Zero-shot و Few-shot
دو روش اصلی برای اجرای زنجیره تفکر وجود دارد: در Zero-shot CoT فقط یک دستور ساده به مدل میدهید، و در Few-shot CoT چند نمونه حلشده همراه با مراحل استدلال را در پرامپت میگذارید. انتخاب بین این دو روش پرامپتنویسی به پیچیدگی مسئله، حساسیت به قالب خروجی و بودجه توکن بستگی دارد.
روش Zero-shot CoT و عبارت «گامبهگام فکر کن»
در روش پرامپتنویسی Zero-shot هیچ مثالی نمیدهید و فقط از مدل میخواهید استدلالش را بنویسد. این ایده در سال ۲۰۲۲ در مقالهای از تاکشی کوجیما (Kojima) و همکاران با عبارت معروف «Let's think step by step» مطرح شد و نشان داد همین یک جمله میتواند کیفیت استدلال مدل را بهشدت بهبود دهد. معادل فارسی آن «گامبهگام فکر کن» یا «مرحلهبهمرحله استدلال کن» است.
قالب پرامپت آماده (Zero-shot CoT):
.
[شرح مسئله]
مسئله را گامبهگام تحلیل کن و مراحل استدلال را بنویس.
در پایان، جواب نهایی را در یک خط جداگانه و با عنوان «پاسخ نهایی:» بیاور.
مثال فارسی (دیباگ کد برنامهنویسی):
.
این تابع پایتون بهجای میانگین، همیشه عدد ۰ برمیگرداند. علت را پیدا کن.
ابتدا کد را خطبهخط بخوان، مقدار هر متغیر را در هر مرحله بنویس،
سپس منبع خطا را مشخص کن و نسخه اصلاحشده را بده.
- مزیت: سریع و کوتاه است و نیازی به ساخت مثال ندارد.
- عیب: قالب و عمق استدلال را مدل خودش تعیین میکند و ممکن است خروجی در دفعات مختلف یکدست نباشد.
روش Few-shot CoT و ارائه نمونههای استدلال
در Few-shot CoT چند نمونه کامل (سؤال، استدلال گامبهگام، پاسخ) را قبل از سؤال اصلی در پرامپت میآورید تا مدل سبک، منطق و عمق استدلال شما را تقلید کند (یادگیری در زمینه یا In-Context Learning). این روش همان رویکرد اصلی مقاله Wei و همکاران است.
مثال فارسی (تحلیل داده مالی):
.
سؤال: فروش یک فروشگاه در فروردین ۲۰۰ میلیون و در اردیبهشت ۲۳۰ میلیون تومان بوده است. رشد چند درصد است؟
استدلال: اختلاف فروش = ۲۳۰ − ۲۰۰ = ۳۰ میلیون. رشد = ۳۰ ÷ ۲۰۰ = ۰٫۱۵ یعنی ۱۵٪.
پاسخ: ۱۵٪
سؤال: فروش در خرداد از ۲۳۰ به ۲۰۷ میلیون تومان رسید. تغییر چند درصد است؟
استدلال: فروش ۲۳ میلیون کم شده است (۲۳۰ منهای ۲۰۷). نسبت کاهش = ۲۳ ÷ ۲۳۰ = ۰٫۱ یعنی ۱۰٪ کاهش.
پاسخ: ۱۰٪ کاهش
سؤال: [سؤال جدید شما]
استدلال:
نکات تجربی برای انتخاب مثال خوب در Few-shot:
- مثالها را دقیقاً از همان جنس مسئلهای انتخاب کنید که از مدل میخواهید حل کند.
- مراحل را ریز و منطقی بنویسید، ولی بیش از حد طولانی نکنید.
- قالب ساختاری همه مثالها یکسان باشد (سؤال، استدلال، پاسخ).
- دو تا پنج مثال معمولاً کافی است؛ تنوع سناریوها در مثالها مهمتر از تعداد آنهاست.
- برای متون تخصصی مثل متن حقوقی، مثالها باید ساختار استاندارد «ماده یا قاعده قانونی، تطبیق با واقعه، نتیجه» را نشان دهند.
جدول مقایسه Zero-shot و Few-shot CoT (کدام روش را کی انتخاب کنیم؟)
| معیار مقایسه | روش Zero-shot CoT | روش Few-shot CoT |
| پیچیدگی مسئله | ساده تا متوسط | متوسط تا پیچیده و تخصصی |
| کنترل قالب خروجی | کم | زیاد و دقیق |
| هزینه مصرف توکن | کمتر | بیشتر (بهخاطر تکرار مثالها در ورودی) |
| زمان آمادهسازی پرامپت | چند ثانیه | چند دقیقه برای طراحی مثالهای استاندارد |
| بهترین کاربرد | پرسشهای روزمره و یکباره | کارهای تکرارشونده، سیستمهای نرمافزاری و خروجی ساختاریافته |
قاعده عملی: همیشه از Zero-shot شروع کنید. اگر دیدید نتیجه ناپایدار است یا قالب خروجی بسیار دقیقی میخواهید، سراغ طراحی مثالهای Few-shot بروید.
زنجیره تفکر در مدلهای استدلالی: چه زمانی «گامبهگام» لازم نیست؟
در نسل جدید مدلهای استدلالی (Reasoning Models) معمولاً لازم نیست دستور «گامبهگام فکر کن» را در پرامپت بنویسید، چون این مدلها پیش از نمایش پاسخ نهایی، فرایند زنجیره تفکر و استدلال درونی خود را بهصورت خودکار انجام میدهند.
مدلهایی که با یادگیری تقویتی (Reinforcement Learning) برای فکر کردن طولانی آموزش دیدهاند — مانند خانواده مدلهای o از OpenAI (مثل o1 و o3)، مدل DeepSeek-R1، قابلیت Extended Thinking در Claude و حالت Thinking در مدلهای Gemini — خودشان در لایه پنهان مسئله را میشکنند، فرضیهها را میسنجند و خطاهایشان را اصلاح میکنند. در چنین مدلهایی، نوشتن دستورهای ریزمرحلهای گاهی حتی نتیجه معکوس دارد و مدل را از مسیر بهینه خودش دور میکند.
تفاوت پرامپتنویسی در مدلهای معمولی و مدلهای استدلالی
| ویژگی | مدلهای زبانی معمولی (Standard LLMs) | مدلهای استدلالی (Reasoning Models) |
| نحوه استدلال | فقط با درخواست صریح کاربر در متن خروجی | درونی، خودکار و پیش از تولید پاسخ نهایی |
| پرامپت مناسب | دستور «گامبهگام فکر کن» یا ارائه مثالهای Few-shot | بیان شفاف هدف نهایی، زمینه (Context) و محدودیتها |
| خطر دستورهای اضافی | کم | کاهش کیفیت استدلال یا افزایش بیدلیل زمان و هزینه |
با این حال، درخواست ساختاردهی صریح حتی در مدلهای استدلالی نیز در ۴ حالت زیر مفید است:
- وقتی قالب خروجی دقیق میخواهید (مثلاً خروجی در قالب جدول یا فایل JSON همراه با ستون توجیه هر ردیف).
- وقتی لازم است مراحل استدلال در متن نهایی چاپ شود تا برای ممیزی، آموزش به تیم یا گزارش به کارفرما مستند بماند.
- وقتی به دلیل محدودیت هزینه یا سرعت (Latency)، با یک مدل کوچک (Mini/Flash) یا مدل غیراستدلالی کار میکنید.
- وقتی روش تحلیل سازمان شما یک رویه استاندارد (SOP) مشخص دارد (مثلاً چکلیست ۱۰ مرحلهای بازبینی قرارداد) و میخواهید مدل دقیقاً همان ترتیب را طی کند.
قاعده ساده: به مدل استدلالی بگویید «چه خروجی و با چه محدودیتی میخواهید»؛ اما به مدل معمولی علاوه بر آن، «چگونه فکر کند» را هم بگویید.
روشهای پیشرفته استدلال مرتبط با CoT: Self-Consistency، Tree of Thoughts و ReAct
سه چارچوب پیشرفته بر پایه زنجیره تفکر ساخته شدهاند تا ضعفهای CoT خطی را پوشش دهند: روش Self-Consistency دقت را با نمونهگیری چندباره بالا میبرد، Tree of Thoughts مسیرهای استدلال را مثل درخت جستوجو میکند و ReAct استدلال زبانی را با فراخوانی ابزارهای بیرونی ترکیب میکند.
- Self-Consistency (خودسازگاری): مستقیمترین توسعه CoT است. در این روش بهجای تولید یک زنجیره، چند زنجیره استدلال مستقل (با تنظیم پارامتر Temperature یا دمای نمونهگیری بالاتر) تولید میکنید و در نهایت پاسخی را انتخاب میکنید که بیشترین تکرار (رأی اکثریت) را بین خروجیها دارد. منطق این روش که توسط وانگ (Wang) و همکاران در سال ۲۰۲۲ معرفی شد این است که مسیرهای درست استدلال معمولاً به یک جواب واحد میرسند، ولی خطاهای محاسباتی پراکندهاند. هزینه آن، چند برابر شدن مصرف توکن و تعداد فراخوانیهای API است.
- Tree of Thoughts یا ToT (درخت افکار): در CoT ساده فقط یک مسیر خطی دنبال میشود و اگر مدل در گام دوم اشتباه کند، تا انتها در مسیر غلط میرود. در روش Tree of Thoughts مدل در هر گام چند ایده یا مسیر مختلف تولید میکند، خودش هر شاخه را ارزیابی میکند و در صورت رسیدن به بنبست، به عقب برمیگردد (Backtracking). این روش برای مسائلی مثل حل پازل، برنامهریزی استراتژیک و نوشتن خلاق ساختاریافته ایدهآل است.
- ReAct (ترکیب Reasoning و Acting): در این الگو، مدل بین «فکر کردن (Thought)» و «انجام عمل (Action)» (مثل جستوجوی وب، اجرای کد پایتون یا فراخوانی API) حرکت چرخشی دارد و نتیجه مشاهدهشده (Observation) از هر ابزار را وارد گام استدلال بعدی میکند. تفاوتش با CoT این است که استدلال فقط به دانش داخلی مدل محدود نمیماند و به دادههای زنده بیرونی تکیه میکند؛ معماری پایه بسیاری از عاملهای هوشمند (AI Agents) امروزی همین الگوی ReAct است.
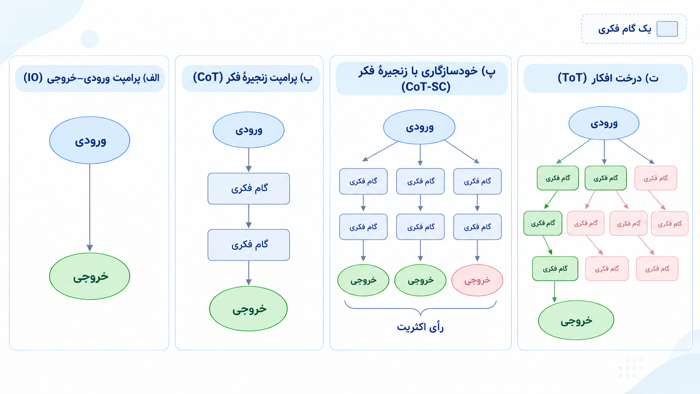
مقایسه ساختار حرکت مدل زبانی در روشهای CoT ساده، Self-Consistency، درخت افکار (ToT) و ReAct
| نام روش | ایده اصلی | بهترین کاربرد | هزینه محاسباتی نسبی |
| CoT ساده | یک زنجیره استدلال خطی | مسائل چندمرحلهای عمومی | کم |
| Self-Consistency | تولید چند زنجیره مستقل و رأیگیری | مسائل دارای پاسخ قطعی (عدد، کد، گزینه) | متوسط تا زیاد |
| Tree of Thoughts (ToT) | جستوجو، ارزیابی و بازگشت در درخت ایدهها | برنامهریزی پیچیده و مسائل اکتشافی | زیاد |
| ReAct | چرخه استدلال به همراه استفاده از ابزار | وظایف نیازمند اطلاعات بیرونی و ایجنتها | متوسط |
محدودیتها و ریسکهای تکنیک زنجیره تفکر
زنجیره تفکر خطاهای هوش مصنوعی را صفر نمیکند، بلکه آنها را شفافتر و قابلردیابیتر میکند. هنگام استفاده از این تکنیک در محیطهای عملیاتی، سه ریسک اصلی زیر را در نظر بگیرید:
توهم هوش مصنوعی (Hallucination) و استدلال نادرست اما قانعکننده
مدل زبانی میتواند زنجیرهای از استدلال بنویسد که در ظاهر کاملاً منطقی، روان و علمی به نظر میرسد، اما در یکی از گامهای میانی دچار توهم هوش مصنوعی (AI Hallucination) یا خطای منطقی شده و به نتیجهای کاملاً نادرست میرسد. حتی پژوهشها نشان دادهاند که گاهی استدلال نوشتهشده، یک توجیه «بعد از واقعه» (Post-hoc Rationalization) است و بازتاب دقیق فرایند محاسباتی شبکه عصبی مدل نیست. بنابراین، روان بودن استدلال هرگز دلیل بر درستی قطعی آن نیست. برای راستیآزمایی:
- محاسبات ریاضی و ارقام کلیدی را جداگانه (با ماشینحساب یا ابزار Code Interpreter) بررسی کنید.
- از مدل بخواهید مسئله را با روشی معکوس دوباره حل کند و پاسخها را بسنجید.
- برای ادعاهای مبتنی بر واقعیت (تاریخ، مواد قانونی، آمار بازار) حتماً به منابع معتبر بیرونی رجوع کنید.
هزینه توکن و تاخیر پاسخ (Latency)
در مدلهای زبانی، شما به ازای هر توکن ورودی و خروجی هزینه میپردازید و زمان منتظر میمانید. از آنجا که در CoT مدل باید تمام مراحل فکر کردن را بنویسد، تعداد توکنهای خروجی بالا میرود؛ نتیجه این کار افزایش هزینه API و بالا رفتن تاخیر پاسخ (Latency) است. در روش Few-shot نیز هزینه توکنهای ورودی (بهخاطر مثالهای طولانی) به این مورد اضافه میشود. برای بهینهسازی، CoT را فقط برای مسائل واقعاً چندمرحلهای به کار ببرید و طول استدلال را در پرامپت محدود کنید (مثلاً: «مراحل استدلال را بهصورت فشرده و در حداکثر ۵ گام بنویس»).
نکات عملی برای کاهش خطا در پرامپتنویسی CoT
- قالب خروجی را تفکیک کنید: به مدل دستور دهید «استدلال را در تگ یا بخش اول و پاسخ نهایی را در یک خط جدا بنویس» تا استخراج نتیجه در کدنویسی یا خوانش چشمی آسان شود.
- پاسخ نهایی را ممیزی کنید: مخصوصاً در کاربردهای حساس مالی، حقوقی و پزشکی به استدلال مدل اکتفا نکنید.
- از دستورهای کلی و مبهم پرهیز کنید: عبارتی مثل «خوب و دقیق فکر کن» به اندازه دستور ساختاریافتهای مثل «ابتدا دادههای ورودی را فهرست کن، سپس فرمول را بنویس و در نهایت جایگذاری کن» کارایی ندارد.
- مثالهای Few-shot را با دقت بازبینی کنید: وجود کوچکترین خطای منطقی یا عدم هماهنگی در مثالهای پرامپت، مستقیماً خطا را به خروجی نهایی منتقل میکند.
- استدلال میانی را از خروجی کاربر نهایی جدا کنید: اگر خروجی پرامپت شما به دست کاربر اپلیکیشن یا سیستم نرمافزاری دیگری میرسد، بخش استدلال را در بکاند جدا کرده و فقط پاسخ نهایی را نمایش دهید.
پرسشهای متداول درباره زنجیره تفکر (FAQ)
تفاوت زنجیره تفکر (CoT) با پرامپت معمولی چیست؟
در پرامپت معمولی (Standard Prompting) فقط پاسخ نهایی از مدل خواسته میشود، اما در تکنیک زنجیره تفکر از مدل میخواهید مراحل رسیدن به پاسخ را هم گامبهگام بنویسد. این کار در مسائل تحلیلی و چندمرحلهای دقت خروجی را بهطور محسوسی بالا میبرد و پیدا کردن منشأ خطا را ساده میکند.
آیا تکنیک CoT روی همه مدلهای هوش مصنوعی کار میکند؟
نه لزوماً. اثر مثبت زنجیره تفکر در مدلهای زبانی بزرگ (LLM) و توانمند بسیار محسوس است، اما در مدلهای زبانی بسیار کوچک ممکن است کمکی نکند یا حتی باعث سردرگمی مدل شود. همچنین در مدلهای استدلالی جدید (مثل o1 یا DeepSeek-R1) معمولاً به دستور صریح CoT نیاز نیست، چون استدلال گامبهگام را بهطور خودکار درونیسازی کردهاند.
آیا CoT با استدلال داخلی مدلها (Reasoning) یکی است؟
خیر، یکی نیستند. زنجیره تفکر (CoT) یک تکنیک پرامپتنویسی است که کاربر در متن دستور خود به کار میبرد. اما استدلال داخلی در مدلهای استدلالی، نتیجه آموزش تخصصی مدل با یادگیری تقویتی است که پیش از تولید پاسخ بهطور خودکار اجرا میشود؛ هرچند هر دو بر یک اصل مشترک تکیه دارند: شکستن مسئله و فکر کردن پیش از پاسخ دادن.
آیا پرامپتنویسی زنجیره تفکر برای زبان فارسی هم کار میکند؟
بله، مدلهای زبانی بزرگ امروزی به زبان فارسی هم استدلال گامبهگام را با دقت بالایی انجام میدهند. با این حال در برخی مسائل بسیار پیچیده منطقی یا کدنویسی، گاهی نوشتن پرامپت به فارسی و درخواست انجام مراحل استدلال به انگلیسی (یا برعکس) نتیجه متفاوتی میدهد؛ بنابراین بهتر است روی مسئله تخصصی خودتان هر دو حالت را بیازمایید.
چه زمانی نباید از تکنیک CoT استفاده کنیم؟
برای پرسشهای دانشی ساده و تکمرحلهای (مثل «پایتخت فرانسه کجاست؟»)، ترجمههای روتین، بازنویسیهای ساده متن و سناریوهایی که در آنها سرعت پاسخگویی (Latency پایین) و هزینه کم توکن مهمتر از استدلال عمیق است، نیازی به استفاده از زنجیره تفکر نیست.
جمعبندی
تکنیک زنجیره تفکر (Chain of Thought) یعنی از مدل زبانی بخواهیم پیش از پریدن به پاسخ نهایی، مسئله را گامبهگام باز کند و حل کند. این روش در مسائل چندمرحلهای دقت هوش مصنوعی را بالا میبرد و خطاهای احتمالی را روی صفحه آشکار میکند. روش Zero-shot CoT برای شروع سریع و پرامپتهای روزمره عالی است و Few-shot CoT زمانی به کار میآید که به قالب خروجی استاندارد و کیفیت پایدار نیاز دارید. در مواجهه با مدلهای استدلالی جدید نیز کافی است هدف و محدودیتها را شفاف بیان کنید و برای چالشهای پیچیدهتر، سراغ الگوهایی مثل Self-Consistency، Tree of Thoughts و ReAct بروید. در نهایت فراموش نکنید که استدلال روان و خوشفرم همیشه به معنای پاسخ درست نیست و خروجی نهایی در کارهای حساس باید راستیآزمایی شود.
تمرین پیشنهادی: یک مسئله واقعی از کار روزانه خودتان انتخاب کنید (مثلاً تحلیل یک جدول فروش ماهانه یا پیدا کردن باگ در یک تکه کد). ابتدا سؤال را بدون هیچ دستور خاصی از مدل بپرسید، بار دوم با افزودن عبارت Zero-shot CoT («گامبهگام تحلیل کن»)، و بار سوم با ارائه دو مثال Few-shot. سه خروجی را از نظر دقت، ساختار و طول پاسخ مقایسه کنید؛ همین آزمایش عملی بهتر از هر تئوری نشان میدهد که زنجیره تفکر چطور خروجی شما را متحول میکند.
 ChatGPT